Imagine passar horas pesquisando, escrevendo e produzindo um artigo para seu site. Você organiza as informações, prepara imagens, revisa o texto, publica e começa a divulgar o conteúdo nas redes sociais.
Algum tempo depois, descobre que uma grande empresa de tecnologia pode utilizar esse material para alimentar sistemas de inteligência artificial, sem necessariamente estabelecer uma negociação individual com quem produziu o conteúdo.
Essa discussão está ganhando importância no mundo digital e chegou a um novo capítulo no Brasil.
No dia 3 de novembro de 2026, a Justiça de São Paulo concedeu uma decisão liminar que impede a Meta de coletar e utilizar conteúdos jornalísticos de veículos associados à Associação Nacional de Jornais (ANJ), à Associação Brasileira de Emissoras de Rádio e Televisão (ABERT) e à Associação Nacional de Editores de Revistas (ANER), sem autorização.
A determinação também impede que esses materiais sejam utilizados para desenvolver, pesquisar e treinar sistemas de inteligência artificial da empresa, incluindo a Meta AI.
A decisão suspendeu parte dos novos termos comerciais da companhia, que estavam previstos para entrar em vigor em 20 de novembro de 2026. Em caso de descumprimento, foi estabelecida multa diária de R$ 1 milhão, limitada a R$ 100 milhões.
ANJ+1
Mas existe uma questão que vai muito além de uma disputa entre uma empresa de tecnologia e grandes grupos de comunicação.
Quem produz conteúdo na internet tem o direito de decidir como suas criações serão utilizadas por sistemas de inteligência artificial?
Essa pergunta interessa não apenas aos grandes jornais, mas também a blogueiros, fotógrafos, designers, desenvolvedores, produtores de vídeos e pequenos empreendedores digitais.
Neste artigo, vamos explicar o que aconteceu, como funciona a coleta automatizada de conteúdo, o que diz a legislação brasileira e quais cuidados os proprietários de sites podem adotar para proteger suas publicações.
O que aconteceu entre a Meta e os veículos de comunicação?
A discussão começou a ganhar força após a Meta apresentar alterações em seus termos comerciais que envolviam a utilização de ferramentas automatizadas para acessar conteúdos publicados em sites de empresas que utilizam suas plataformas.
A preocupação das entidades de comunicação estava relacionada à possibilidade de a empresa acessar, copiar, armazenar e analisar reportagens, fotografias, vídeos e outros materiais publicados nos domínios desses veículos.
Um dos pontos mais questionados era a vinculação entre o uso das plataformas comerciais da Meta e a autorização para coleta desses conteúdos.
Na prática, as entidades argumentaram que os veículos poderiam ficar diante de uma escolha desequilibrada: permitir a utilização de seu patrimônio intelectual ou correr o risco de enfrentar restrições no acesso às ferramentas da empresa.
A ANJ, a ABERT e a ANER decidiram recorrer à Justiça para contestar as mudanças.
Em 3 de novembro, o juiz Guilherme Madeira Dezem, da 44ª Vara Cível de São Paulo, concedeu a liminar solicitada pelas entidades.
A decisão determinou que a Meta não poderia utilizar mecanismos automatizados para coletar os conteúdos dos sites associados sem autorização, nem utilizar esses materiais em seus sistemas de inteligência artificial.
Também estabeleceu que as contas, páginas e ferramentas utilizadas pelos veículos deveriam permanecer funcionando normalmente, sem bloqueios ou retaliações por causa da recusa aos novos termos.
ANJ+1
A decisão já é definitiva?
Não. Esse detalhe é fundamental para compreender corretamente a notícia.
A decisão concedida em novembro é uma liminar, ou seja, uma medida judicial provisória que busca proteger os interesses envolvidos enquanto o processo continua.
Isso significa que não existe ainda um julgamento definitivo sobre todas as questões discutidas pelas partes.
A Meta poderá apresentar sua defesa, e o processo seguirá para análise judicial. A liminar poderá ser mantida, modificada ou revogada durante o andamento da ação.
Portanto, não é correto afirmar que a Justiça brasileira estabeleceu uma proibição definitiva e universal de utilização de conteúdos disponíveis na internet para treinamento de inteligência artificial.
O que existe, neste momento, é uma decisão específica envolvendo a Meta e os veículos representados pelas três entidades autoras.
O que exatamente a Justiça proibiu?
A decisão estabelece restrições importantes para a utilização de conteúdos dos veículos associados às entidades envolvidas.
Entre as determinações estão:
Impedir a coleta automatizada de conteúdos dos sites protegidos pela decisão sem autorização.
Impedir o acesso, a indexação, o armazenamento em cache, a análise e a recuperação desses materiais por mecanismos utilizados pela Meta.
Proibir o uso dos conteúdos protegidos para desenvolver, pesquisar, manter, treinar ou ajustar sistemas de inteligência artificial da empresa.
Impedir que a recusa aos novos termos comerciais resulte em punições ou restrições às contas e ferramentas dos veículos.
Manter os serviços utilizados pelas empresas associadas em pleno funcionamento.
A multa estabelecida é de R$ 1 milhão por dia de descumprimento, limitada a R$ 100 milhões.
A determinação alcança também o uso de softwares ou credenciais de teste para acessar os domínios e conteúdos protegidos pela medida.
UOL+1
É importante observar que a decisão não impede toda e qualquer atividade da Meta envolvendo informações disponíveis na internet. Seu alcance está relacionado aos conteúdos protegidos pela ação e às obrigações determinadas pelo juízo.
O que é web scraping e por que essa tecnologia está no centro da discussão?
Para entender a disputa, precisamos conhecer uma tecnologia utilizada há muitos anos na internet: o web scraping.
Web scraping é uma técnica de coleta automatizada de informações disponíveis em páginas da internet.
Em vez de uma pessoa acessar manualmente dezenas, centenas ou milhares de páginas, um programa realiza as consultas, identifica os elementos existentes e extrai informações de maneira sistemática.
Imagine um robô que visita diferentes páginas de um site e coleta:
Títulos de artigos.
Textos e parágrafos.
Descrições de produtos.
Fotografias e ilustrações.
Informações estruturadas.
Links e referências.
Dados apresentados em tabelas.
Esse tipo de tecnologia pode ser utilizado para diversas finalidades legítimas, como monitoramento de preços, análise de mercado, pesquisa acadêmica e organização de informações públicas.
O problema aparece quando a coleta envolve conteúdos protegidos e sua utilização ocorre sem observar os direitos dos respectivos titulares.
Como os robôs coletam informações de um site?
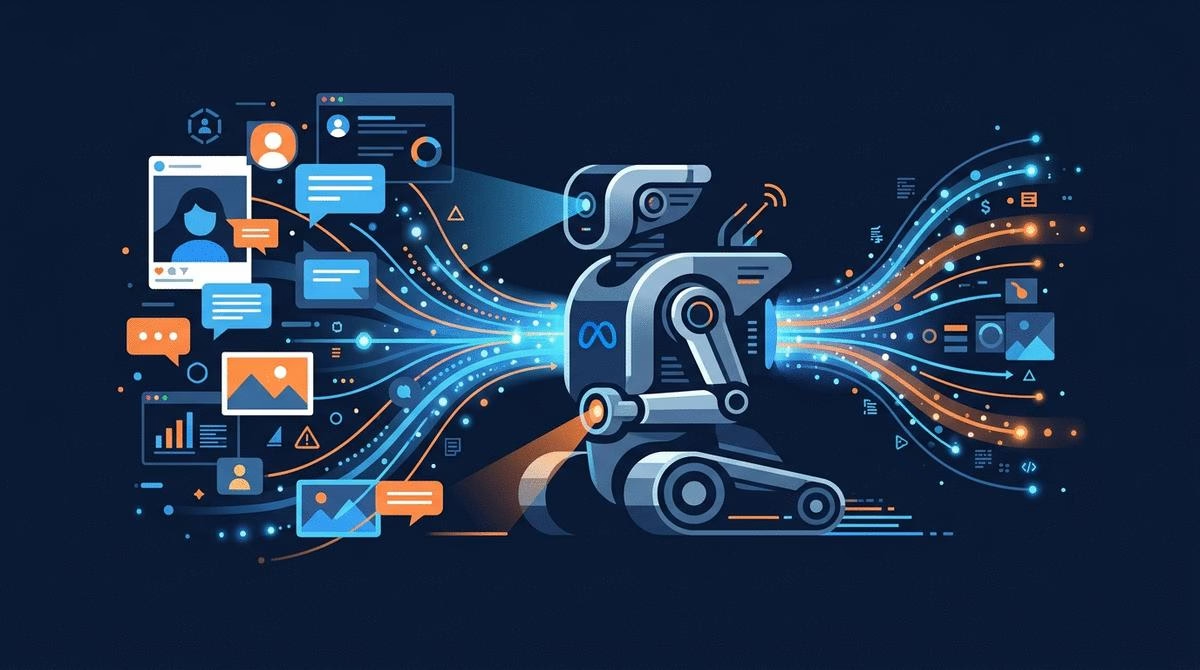
Primeiro, identifica os endereços das páginas que deseja acessar. Depois, realiza requisições aos servidores, recebe o conteúdo disponibilizado e processa as informações encontradas.
Dependendo do projeto, os dados podem ser organizados em bancos de dados, armazenados temporariamente ou enviados para outros sistemas.
Quando essa tecnologia é utilizada em larga escala, torna-se possível coletar quantidades enormes de informações em períodos relativamente curtos.
É justamente essa capacidade que tornou o web scraping importante para o desenvolvimento de algumas aplicações de inteligência artificial.
Como os conteúdos da internet são utilizados para treinar uma inteligência artificial?
Os modelos de inteligência artificial generativa precisam ser desenvolvidos utilizando grandes conjuntos de dados.
Esses conjuntos podem incluir textos, imagens, códigos de programação, documentos e outros materiais, conforme o tipo de modelo e sua finalidade.
Durante o treinamento, o sistema identifica padrões presentes nos dados e ajusta seus parâmetros para aprender relações entre palavras, imagens, conceitos e diferentes estruturas de informação.
No caso de modelos de linguagem, por exemplo, o treinamento permite que o sistema desenvolva a capacidade de prever sequências de palavras, interpretar instruções e produzir respostas coerentes.
É por isso que o conteúdo disponível na internet se tornou tão relevante para as empresas que desenvolvem inteligência artificial.
Artigos técnicos, reportagens, livros, documentações, fóruns e publicações especializadas podem representar fontes de informação importantes para determinados processos de desenvolvimento.
Entretanto, existe uma diferença entre utilizar informações disponíveis para compreender um assunto e reproduzir ou armazenar conteúdos protegidos sem observar os direitos de seus titulares.
Treinamento, ajuste e consulta de conteúdo são coisas diferentes
É importante não confundir três processos que podem parecer semelhantes.
| Processo | Como funciona |
|---|---|
| Treinamento | Utiliza conjuntos de dados para ajustar os parâmetros de um modelo de IA |
| Fine-tuning | Realiza um ajuste adicional de um modelo já treinado utilizando dados específicos |
| RAG ou recuperação de informações | Busca documentos externos para fornecer contexto a uma IA durante a geração de uma resposta |
O treinamento modifica os parâmetros do modelo por meio de um processo de aprendizagem.
O fine-tuning é uma etapa de adaptação que pode melhorar o comportamento do sistema em determinada tarefa.
Já o RAG, conhecido como geração aumentada por recuperação, permite que uma aplicação consulte documentos e bases externas antes de produzir uma resposta, sem necessariamente incorporar esses documentos ao treinamento do modelo.
Essa diferença é relevante porque nem toda utilização de um conteúdo por uma ferramenta de IA representa treinamento.
Um sistema pode consultar uma página para responder a uma pergunta, utilizar um mecanismo de busca para localizar informações ou efetivamente incluir materiais em um conjunto de treinamento.
Cada situação precisa ser analisada conforme a tecnologia utilizada, os direitos envolvidos e as condições de acesso.
O que diz a legislação brasileira sobre direitos autorais?
No Brasil, uma das principais normas sobre o assunto é a Lei nº 9.610/1998, conhecida como Lei de Direitos Autorais.
Ela estabelece regras para proteger obras intelectuais, incluindo textos, fotografias, ilustrações, vídeos, músicas e outras produções.
Um ponto interessante é que a proteção não depende de registro formal.
O artigo 18 estabelece que a proteção aos direitos autorais independe de registro. Isso significa que a criação de uma obra já pode gerar proteção jurídica, desde que estejam presentes os requisitos legais.
Planalto
Publicar na internet não significa abrir mão dos direitos autorais
Existe uma interpretação equivocada de que qualquer material disponível publicamente pode ser utilizado livremente.
Isso não é verdade.
Um artigo publicado em um blog pode ser acessado por qualquer pessoa, mas isso não significa que terceiros tenham autorização automática para reproduzi-lo integralmente, comercializá-lo ou utilizá-lo em qualquer finalidade.
O mesmo raciocínio vale para fotografias, ilustrações, vídeos e outros materiais protegidos.
A Lei nº 9.610/1998 estabelece, no artigo 29, que determinadas modalidades de utilização de obras dependem de autorização prévia e expressa do autor, incluindo reprodução, adaptação e armazenamento em computador.
A legislação também prevê limitações e exceções específicas, como determinadas formas de citação, utilização de pequenos trechos e outras hipóteses previstas no artigo 46.
Planalto
A discussão sobre treinamento de IA envolve justamente a interpretação dessas regras diante de tecnologias que não existiam na mesma escala quando a lei foi criada.
Informações e ideias também são protegidas?
Aqui existe outra distinção importante.
A legislação não protege automaticamente qualquer ideia, conceito, método ou informação isolada.
O artigo 8º da Lei de Direitos Autorais estabelece que ideias, procedimentos, métodos e conceitos matemáticos, por si só, não são objeto de proteção autoral.
Entretanto, a forma original como determinado conteúdo é desenvolvido e apresentado pode receber proteção.
Por exemplo, duas pessoas podem escrever sobre o mesmo lançamento de tecnologia, explicar as mesmas características de um produto ou comentar uma notícia.
O assunto e os fatos não pertencem exclusivamente ao primeiro autor. Mas copiar a estrutura original, os parágrafos, as fotografias e outros elementos protegidos de uma publicação pode representar uma situação diferente.
Essa distinção é especialmente importante para quem produz conteúdo informativo, educacional e jornalístico.
A Meta poderá continuar utilizando conteúdos de outros sites?
A decisão judicial não representa uma proibição automática para todos os sites da internet.
Esse é um dos pontos que merecem maior atenção.
A liminar foi concedida em uma ação apresentada pela ANJ, pela ABERT e pela ANER, beneficiando os veículos associados às entidades dentro do alcance da decisão.
Isso significa que um pequeno blog independente, uma loja virtual ou um site institucional não passa automaticamente a integrar o grupo protegido pela liminar.
A decisão também não estabelece que todas as empresas de inteligência artificial estejam proibidas de utilizar qualquer conteúdo disponível na internet.
Cada situação pode envolver condições contratuais, direitos autorais, licenças, exceções legais e circunstâncias técnicas diferentes.
Portanto, o resultado desse processo poderá influenciar discussões futuras, mas não deve ser interpretado como uma regra universal já estabelecida.
O que muda para pequenos blogs, sites e criadores de conteúdo?
Essa talvez seja a parte mais interessante da discussão para quem trabalha com internet.
Durante muito tempo, a preocupação de quem publica conteúdo estava concentrada em evitar cópias realizadas por outros sites, perfis de redes sociais e páginas que reproduziam artigos sem autorização.
Com o crescimento da inteligência artificial, surgiu uma nova questão: como controlar ou negociar a utilização de conteúdos publicados na internet por sistemas automatizados?
Um artigo pode ser resultado de horas de pesquisa. Uma fotografia pode exigir equipamento, conhecimento técnico e trabalho de edição. Uma ilustração pode representar uma criação original desenvolvida durante vários dias.
Quando esses materiais são utilizados em sistemas comerciais, os produtores passam a discutir questões relacionadas à remuneração, ao reconhecimento da autoria e ao controle sobre a utilização de suas obras.
Pequenos produtores também possuem direitos autorais
Não é necessário ser uma grande empresa jornalística para produzir uma obra protegida.
Um blogueiro pode criar textos originais, um fotógrafo pode produzir imagens próprias e um designer pode desenvolver ilustrações para clientes.
Essas criações podem receber proteção autoral independentemente do tamanho do site ou da quantidade de visitantes.
O desafio é conseguir demonstrar a autoria, identificar usos não autorizados e estabelecer condições claras para o licenciamento dos materiais.
O conteúdo do seu site pode ser utilizado por ferramentas de IA?
Se um artigo estiver publicamente acessível, mecanismos automatizados poderão tecnicamente encontrá-lo e tentar coletar suas informações.
Isso não significa que qualquer utilização será necessariamente permitida.
É importante distinguir a possibilidade técnica de acessar uma página da autorização jurídica para reproduzir, armazenar ou explorar comercialmente uma obra.
Também vale lembrar que os direitos podem pertencer a pessoas diferentes dependendo da forma como o conteúdo foi produzido.
Um artigo pode ter sido escrito por um freelancer, uma fotografia pode pertencer a um banco de imagens e uma ilustração pode estar licenciada por terceiros.
Por isso, o proprietário do site precisa conhecer os direitos efetivamente disponíveis sobre cada material publicado.
Como proteger o conteúdo do seu site contra utilização indevida?
Não existe uma ferramenta única capaz de impedir completamente a coleta de informações disponíveis publicamente.
Entretanto, algumas medidas podem ajudar a organizar os direitos sobre as publicações, facilitar a identificação de cópias e melhorar o controle técnico do site.
1. Identifique claramente a autoria dos conteúdos
Procure manter informações sobre quem produziu os artigos, fotografias, ilustrações e outros materiais.
Uma página de autoria, identificação do responsável pelo conteúdo e informações institucionais ajudam a estabelecer a origem das publicações.
No WordPress, também é interessante manter os registros de edição e as revisões dos artigos sempre que possível.
2. Preserve os arquivos originais e o histórico de produção
Guarde documentos que ajudem a demonstrar como o material foi produzido.
Entre eles estão:
Rascunhos e versões anteriores dos artigos.
Fotografias originais e arquivos de edição.
Arquivos-fonte de ilustrações e projetos gráficos.
Comprovantes de contratação de profissionais.
Contratos de licenciamento.
Registros de publicação e alterações no WordPress.
Cópias de segurança periódicas.
Esses registros podem ajudar a demonstrar a autoria e a data de criação de determinado conteúdo em uma eventual disputa.
3. Tenha termos de uso e uma política de direitos autorais
Um site profissional deve apresentar informações claras sobre a utilização de seus materiais.
É possível informar que textos, fotografias, ilustrações e outros conteúdos não podem ser reproduzidos ou comercializados sem autorização, ressalvadas as utilizações permitidas pela legislação.
Também é interessante disponibilizar um canal de contato para solicitações de licenciamento e utilização comercial.
Isso não impede tecnicamente que alguém copie o material, mas deixa mais claras as condições de utilização estabelecidas pelo titular.
4. Configure o robots.txt com atenção
O arquivo robots.txt permite indicar aos mecanismos automatizados quais partes de um site podem ou não ser acessadas por determinados rastreadores.
Ele pode ser utilizado para comunicar preferências de rastreamento a mecanismos de busca e outros crawlers que respeitem o protocolo.
Entretanto, existe uma limitação importante: o robots.txt não é um mecanismo de autenticação nem uma barreira de segurança.
A especificação RFC 9309, publicada pela Internet Engineering Task Force (IETF), deixa explícito que as regras desse arquivo não representam uma autorização de acesso. Portanto, um robô que não respeita as instruções ainda pode tentar acessar as páginas.
rfc-editor.org
Também é importante não bloquear indiscriminadamente os rastreadores de mecanismos de busca, pois isso pode prejudicar a descoberta e a indexação das páginas.
A configuração deve considerar quais serviços você deseja permitir e quais prefere restringir.
5. Utilize proteção técnica para áreas privadas
Se o site possui documentos, materiais exclusivos ou conteúdos que não devem ser acessados publicamente, utilize mecanismos reais de controle de acesso.
Entre as possibilidades estão:
Autenticação por usuário e senha.
Proteção de diretórios.
Restrições de acesso no servidor.
Firewall de aplicações web (WAF).
Limitação de requisições automatizadas.
Monitoramento de acessos suspeitos.
Essas ferramentas são diferentes do robots.txt porque podem efetivamente restringir o acesso aos recursos protegidos.
Ainda assim, nenhum mecanismo impede completamente que um usuário autorizado copie o material ao qual recebeu acesso.
6. Monitore possíveis cópias de suas publicações
É interessante acompanhar se outros sites estão reproduzindo seus artigos, imagens e materiais originais.
Quando identificar uma possível utilização irregular, registre as evidências antes de tomar qualquer providência.
Guarde os endereços das páginas, capturas de tela, datas de acesso e informações que permitam comparar os materiais.
Dependendo do caso, pode ser necessário entrar em contato com o responsável pelo site, solicitar a retirada do conteúdo ou buscar orientação jurídica.
O que é possível fazer no WordPress para organizar esses direitos?
Para quem administra um blog em WordPress, a proteção começa pela organização editorial e técnica.
Não é necessário transformar o site em uma estrutura complexa, mas algumas práticas ajudam bastante.
| Recurso | Finalidade |
|---|---|
| Revisões de publicação | Preservar versões anteriores dos artigos |
| Backup automático | Manter cópias de segurança do conteúdo |
| Página de termos de uso | Informar condições de utilização |
| Política de direitos autorais | Identificar restrições e canais de autorização |
| robots.txt | Comunicar preferências de rastreamento |
| Firewall/WAF | Ajudar a filtrar acessos automatizados suspeitos |
| Logs do servidor | Investigar padrões de acesso e requisições |
Um ponto adicional merece atenção: imagens de produtos, fotografias de fabricantes e materiais de bancos de imagens não se tornam automaticamente propriedade do administrador do blog apenas porque foram enviados para a biblioteca de mídia do WordPress.
É necessário respeitar as condições de licença e utilização de cada material.
Para quem utiliza ferramentas de IA na produção de conteúdo, também vale conferir nosso artigo Como usar Inteligência Artificial sem expor seus dados: 7 cuidados essenciais.
A inteligência artificial pode utilizar qualquer informação encontrada no Google?
Não existe uma resposta simples para essa pergunta.
Encontrar uma página nos resultados de busca não significa que todos os seus conteúdos estejam livres de direitos autorais.
Os mecanismos de busca e os sistemas de inteligência artificial possuem finalidades e processos diferentes.
Um buscador pode localizar uma publicação, armazenar informações para indexação e apresentar um resultado com título, descrição e endereço da página.
Já um sistema de IA pode utilizar conteúdos em processos de treinamento, recuperação de informações, ajuste de modelos ou geração de respostas.
Essas atividades não devem ser tratadas como se fossem a mesma coisa.
A existência de uma página pública também não significa que o autor tenha concedido uma licença irrestrita para qualquer finalidade comercial.
Por isso, é importante avaliar as regras aplicáveis a cada forma de utilização.
O que acontece com os sites que utilizam inteligência artificial para produzir artigos?
A discussão também levanta uma questão interessante para quem trabalha com produção de conteúdo utilizando IA.
Se uma empresa de tecnologia precisa respeitar direitos autorais sobre materiais de terceiros, os produtores de conteúdo também devem ter cuidado ao utilizar sistemas automatizados.
Uma ferramenta de IA pode ajudar a pesquisar, estruturar e revisar um artigo, mas isso não significa que o usuário possa copiar indiscriminadamente materiais protegidos para construir uma publicação.
É importante verificar as informações, desenvolver uma abordagem própria, conferir as fontes e utilizar imagens e outros recursos de maneira legítima.
Para um blog que pretende construir autoridade nos mecanismos de busca, a originalidade editorial continua sendo um fator importante.
O conteúdo deve oferecer informação útil, análise, contexto e valor ao leitor, em vez de apenas reproduzir materiais encontrados em outros sites.
O uso de IA não elimina a responsabilidade editorial
Mesmo quando uma ferramenta participa da produção de um artigo, alguém precisa responder pela publicação.
É necessário verificar dados, corrigir erros, avaliar as fontes, conferir os direitos sobre imagens e revisar as informações antes de disponibilizar o material ao público.
A inteligência artificial pode acelerar determinadas etapas, mas não substitui a responsabilidade de quem administra o site.
Essa disputa pode mudar a relação entre sites e empresas de inteligência artificial?
É possível que sim.
A decisão brasileira coloca em evidência uma discussão que já acontece em outros mercados: qual deve ser a relação comercial e jurídica entre quem produz conteúdo e quem desenvolve sistemas de inteligência artificial?
Existem diferentes caminhos possíveis.
Um deles é a negociação direta de licenças, permitindo que empresas de IA utilizem determinados materiais mediante condições estabelecidas entre as partes.
Outro envolve mecanismos de identificação e respeito às preferências dos proprietários de sites sobre o acesso de rastreadores.
Também podem surgir modelos de remuneração, parcerias de distribuição de conteúdo e acordos específicos para utilização de bases de dados.
O desafio será encontrar um equilíbrio entre inovação tecnológica, acesso à informação e proteção da propriedade intelectual.
O conteúdo pode se tornar um ativo comercial ainda mais importante
Durante muitos anos, produzir conteúdo para a internet foi visto principalmente como uma estratégia de divulgação, geração de tráfego e construção de audiência.
Com a expansão da inteligência artificial, os materiais originais também passaram a despertar interesse como possíveis fontes de informação para sistemas automatizados.
Isso pode aumentar a importância de conteúdos especializados, bancos de dados organizados, fotografias próprias, documentação técnica e publicações de qualidade.
O próprio desenvolvimento da infraestrutura de inteligência artificial depende de grandes investimentos em processamento e armazenamento de informações.
Para entender melhor essa relação, vale conferir nosso artigo Redata 2026: o que muda para os data centers, a IA e a tecnologia no Brasil.
O que podemos esperar dos próximos passos do processo?
A liminar representa uma vitória inicial das entidades que entraram com a ação, mas ainda existem questões importantes que deverão ser analisadas.
Entre os principais pontos de acompanhamento estão:
A defesa da Meta: a empresa poderá apresentar seus argumentos sobre as mudanças contratuais e a utilização de conteúdos de terceiros.
A continuidade da liminar: será necessário acompanhar se as determinações permanecerão em vigor durante o processo.
A interpretação dos direitos autorais: o caso poderá contribuir para esclarecer como a legislação brasileira se aplica à coleta automatizada e à utilização de conteúdos por sistemas de IA.
O alcance das medidas: será importante acompanhar se a discussão poderá resultar em novos acordos ou ações envolvendo outros produtores de conteúdo.
A relação comercial com os veículos: o processo pode estimular negociações sobre licenciamento e utilização de materiais jornalísticos.
A Meta informou ao UOL que não comentaria a decisão judicial. Antes disso, em manifestação publicada em 28 de outubro, seu porta-voz havia indicado que a empresa pretendia consultar representantes do setor antes de adotar as mudanças nos termos comerciais.
UOL
Checklist: como um produtor de conteúdo pode se preparar?
Se você administra um blog, site, portal ou trabalha com produção de materiais digitais, vale começar por algumas medidas práticas:
Essas medidas não garantem que um material nunca será copiado, mas ajudam a organizar a gestão dos direitos e a demonstrar a origem das publicações.
Afinal, quem produz conteúdo terá mais controle sobre o treinamento das IAs?
A decisão da Justiça de São Paulo representa um passo importante na discussão sobre direitos autorais e inteligência artificial no Brasil.
Ela demonstra que a utilização de conteúdos publicados na internet pode gerar questionamentos jurídicos, principalmente quando envolve coleta automatizada, reprodução, armazenamento e exploração comercial.
Mas é importante manter as expectativas equilibradas.
A liminar não protege automaticamente todos os sites brasileiros, não encerra o debate sobre treinamento de IA e não significa que qualquer utilização de informações disponíveis na internet seja proibida.
O que ela evidencia é a necessidade de estabelecer regras mais claras sobre a relação entre plataformas digitais, empresas de inteligência artificial e produtores de conteúdo.
Para quem trabalha com internet, existe uma lição importante: produzir conteúdo original continua sendo um investimento, e conhecer os direitos relacionados a esse material faz parte da administração de um negócio digital.
A inteligência artificial pode transformar a maneira como a informação é produzida e consumida. Mas a valorização de quem cria essa informação também precisa fazer parte dessa transformação.
Continue acompanhando o Blog Plano na Web para entender as mudanças da inteligência artificial, da tecnologia e do mercado digital.
Perguntas frequentes (FAQ)
A Meta está proibida de utilizar qualquer conteúdo da internet para treinar IA?
Não. A liminar concedida em São Paulo é específica e protege os conteúdos dos veículos associados à ANJ, à ABERT e à ANER dentro do alcance da decisão. Ela não representa uma proibição universal de utilização de conteúdos disponíveis na internet por todas as empresas de IA.
A Justiça proibiu a Meta de treinar a Meta AI?
A decisão impede a utilização, sem autorização, dos conteúdos protegidos dos veículos associados para desenvolver, pesquisar, manter, treinar, ajustar ou alimentar os sistemas de inteligência artificial da Meta, incluindo a Meta AI. A medida é provisória e está sujeita ao andamento do processo.
Qual é o valor da multa aplicada à Meta?
A liminar estabelece multa diária de R$ 1 milhão em caso de descumprimento, limitada a R$ 100 milhões.
A decisão também protege blogs pequenos?
Não automaticamente. A liminar foi concedida em ação apresentada por três entidades de comunicação e seu alcance está relacionado aos veículos associados protegidos pela decisão. Blogs independentes possuem direitos autorais próprios, mas não passam automaticamente a integrar o grupo beneficiado.
O que é web scraping?
É uma técnica de coleta automatizada de informações de páginas da internet. Pode ser utilizada para pesquisa, análise de mercado, monitoramento de preços e diferentes aplicações, mas sua utilização precisa respeitar os direitos e as condições de acesso aos conteúdos envolvidos.
O arquivo robots.txt impede que uma IA copie meu site?
Não. O robots.txt comunica instruções de rastreamento para mecanismos automatizados que respeitam o protocolo, mas não funciona como uma barreira de segurança. Um robô pode ignorar essas instruções.
Meu artigo publicado no WordPress possui direitos autorais?
Sim. Textos originais podem receber proteção pela legislação brasileira. O artigo 18 da Lei nº 9.610/1998 estabelece que essa proteção independe de registro formal, observadas as condições legais aplicáveis.
Posso proibir que empresas utilizem meus artigos para treinar IA?
Você pode estabelecer condições de utilização e licenciamento dos seus conteúdos, mas a eficácia jurídica de uma proibição depende da legislação aplicável, dos direitos envolvidos e das circunstâncias concretas. Uma simples declaração no rodapé ou no robots.txt não resolve todas as situações.
A inteligência artificial pode utilizar artigos encontrados no Google?
A indexação por um mecanismo de busca não significa que todo conteúdo esteja livre para qualquer utilização. É necessário distinguir a descoberta de uma página, sua indexação, a consulta de informações e a reprodução ou utilização de obras protegidas.
A liminar já é uma decisão definitiva?
Não. É uma decisão provisória, concedida durante o andamento do processo. O mérito da disputa ainda poderá ser analisado pela Justiça.
Convite para você
Gostou de entender essa mudança?
Continue acompanhando o Blog Plano na Web para ficar por dentro das novidades sobre inteligência artificial, tecnologia, ferramentas digitais e oportunidades que estão transformando a internet.